Обычный ИИ-агент без специальной обвязки упирается в лимит контекста модели уже на десятках тысяч строк данных — загрузить туда 700 000 записей просто невозможно физически.
ИИ-агент, обученный работать как аналитик данных, решает эту задачу иначе: он опирается на статистику по набору данных, а не читает каждую строку, — в одной из демонстраций такой подход занял около 130 000 токенов на анализ трёх связанных источников общим объёмом более 700 000 записей. Дальше — что именно происходит внутри и почему это не просто «более быстрый» способ, а принципиально другой.
Почему лимит контекста — это не техническая деталь, а стена
У любой языковой модели есть предел объёма данных, которые она может удерживать «в голове» одновременно — окно контекста. Как только объём данных превышает этот предел, обычный агент не может просто загрузить их и начать работать: он либо откажется от задачи, либо начнёт обрабатывать данные частями без понимания связей между ними, теряя точность. Для задач с 700 000 записей в одной таблице это не редкое исключение, а типичный объём данных о продажах компании за пару лет.
Как агент обходит это ограничение: статистика вместо построчного чтения
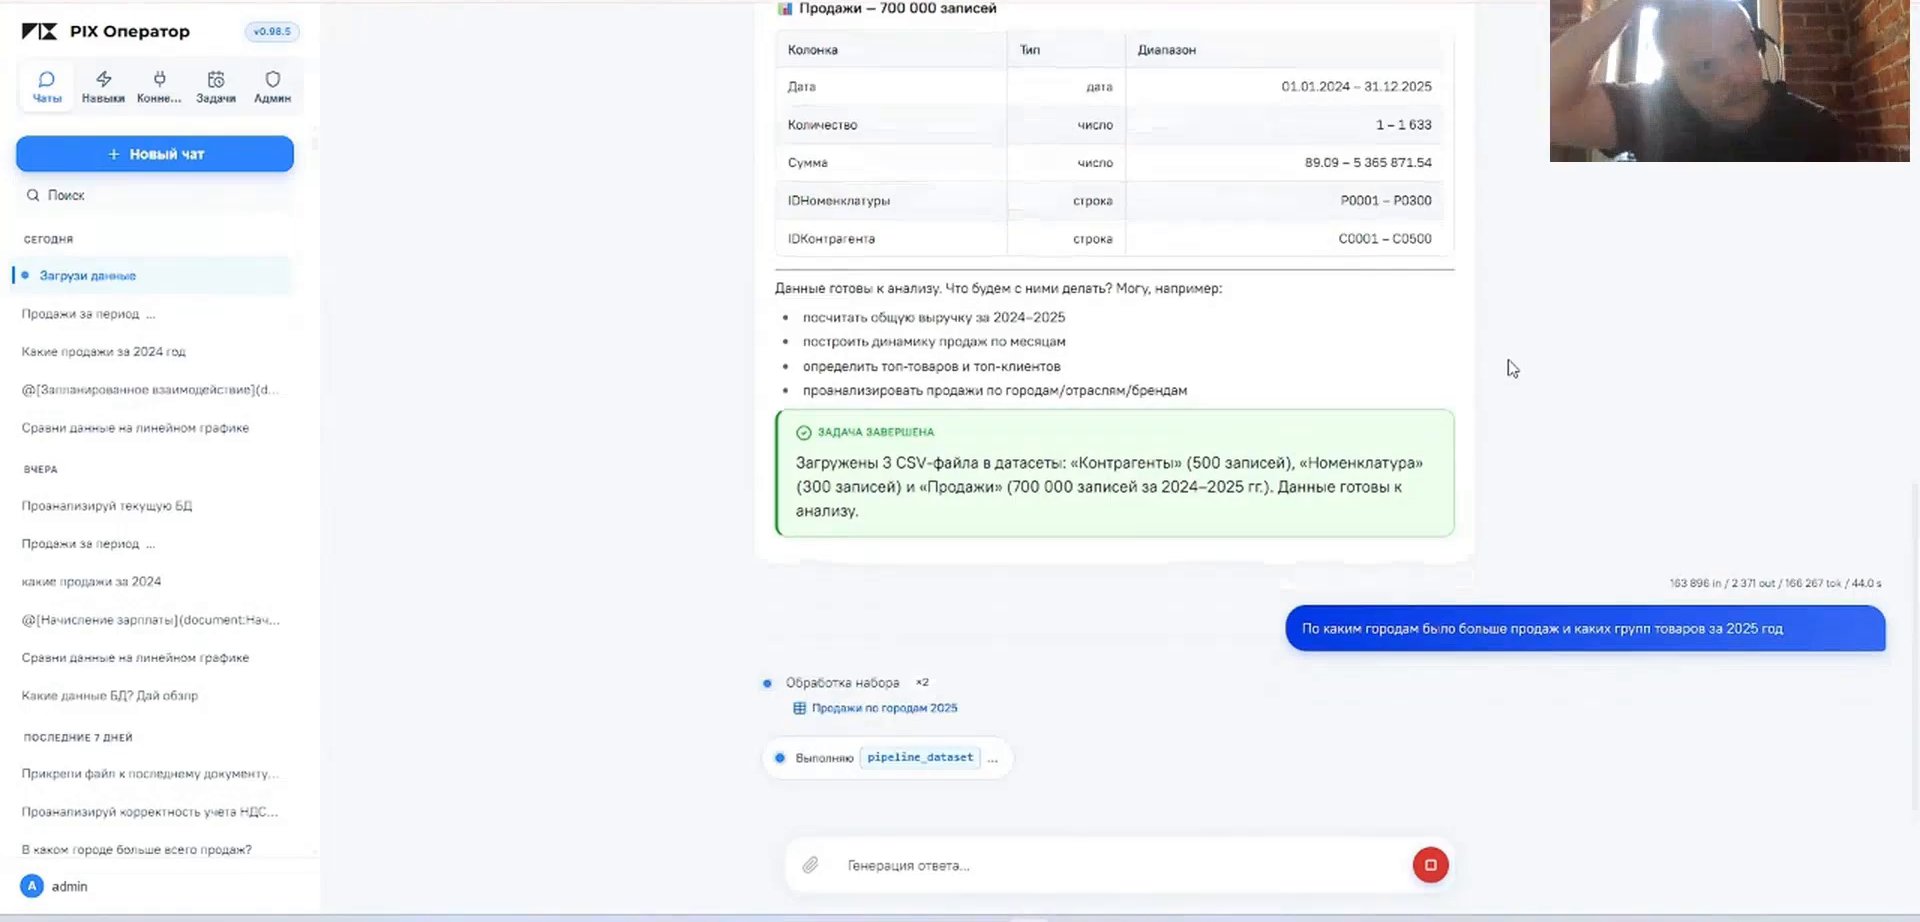
В демонстрации PIX Оператор получил три файла из разных источников — контрагенты, номенклатура и продажи (700 000 записей за 2024–2025 годы) — и не получил от пользователя никаких пояснений, как эти данные связаны между собой. Агент сам изучил структуру каждого файла и связи между ними.
Дальше — ключевое отличие. Аналитик, разбирая большой набор данных, не читает каждую строку одну за другой — он смотрит на статистику: какие есть периоды, суммы, выбросы, диапазоны значений. Именно так работает и агент: он видит все записи как набор, но анализирует его статистически, а не построчным чтением. Это позволяет ему отвечать на нестандартные аналитические вопросы («по каким городам было больше всего продаж и каких групп товаров за 2025 год») без предварительно настроенного отчёта под конкретно эту формулировку.
Результат: конкретные цифры демонстрации
На выполнение этого запроса — который потребовал связать три таблицы, сделать ряд трансформаций и группировок и вытащить данные из соседних таблиц — агент потратил около 130 000 токенов. Для контекста: «стоимость мышления» ИИ-модели считается именно в токенах, и это довольно скромный объём для задачи такого масштаба, особенно учитывая, что исходный набор данных — 700 000 строк, которые в принципе невозможно было бы просто «показать» модели целиком.
От анализа к интерактивному дашборду
На вебинаре 30 сентября 2026 года тот же набор данных (два справочника и факт продаж на 700 тысяч строк) разобрали заново, уже с новыми возможностями агента. На запрос «проанализируй эти данные для меня как для коммерческого директора» без указания конкретных показателей агент за 1 минуту 39 секунд подготовил отчёт с общей картиной, рейтингами и ключевыми выводами.
По следующему запросу «возьми данные из предыдущего запроса и сформируй дашборд» агент вспомнил прошлый анализ и построил интерактивный дашборд: рейтинги, столбчатые диаграммы и ABC-анализ, с перечнем файлов-источников и датой обновления. На любой элемент можно навести курсор и посмотреть значение. Готовый дашборд агент отправил на почту. Строить дашборды PIX Оператор научился в обновлении конца сентября 2026 года. В демонстрации на один дашборд уходило около двух минут.
Демонстрация целиком есть в записи вебинара «ИИ-агент в корпоративных системах: помощник для 1С, почты и Битрикс24».
Прямая работа с базой, а не только с выгрузками
Тот же принцип работает не только с загруженными файлами, но и с прямым подключением к базам данных. Помимо 1С, агент может подключаться напрямую к PostgreSQL, MS SQL и к ClickHouse — колоночной СУБД, которая изначально проектировалась для тяжёлой аналитики на больших объёмах. Для действительно больших и сложных аналитических запросов это даёт дополнительный запас: вычисления можно переложить на саму аналитическую базу вместо того, чтобы выгружать данные и обрабатывать их на стороне агента. Тот же подход применим и к связке с BI-системой — агент не просто показывает уже готовый дашборд, а обращается за исходными данными напрямую и строит аналитику по актуальному запросу, а не по вчерашнему кешу.
Подключение агента напрямую к вашей базе делаем в рамках внедрения ИИ в 1С.
Почему это не получится сделать в обычном агенте
Если попробовать решить такую же задачу в универсальном ИИ-агенте без встроенных инструментов для работы с данными, есть два реалистичных исхода: либо агент откажется от задачи из-за лимита контекста, либо (если это кодовый агент) сможет написать программный код для чтения и анализа файлов — но такой подход менее безопасен для корпоративного контура и не даёт встроенных механизмов контроля доступа. Разбор того, как PIX Оператор решает вопрос безопасности при работе с данными в закрытом контуре — в статье «Три уровня безопасности ИИ-агента при работе с 1С».
Такая работа с данными — часть более широкой механики PIX Оператора, отличающей его от RPA-робота и чат-бота: подробнее — в статье «Чем PIX Оператор отличается от RPA-робота и чат-бота». Пример такого агента для работы с 1С и бизнес-системами — PIX Оператор.
Частые вопросы
Сколько данных может обработать ИИ-агент за один запрос?
В демонстрации агент работал с набором из 700 000 записей — при этом лимит по умолчанию для базовой установки составляет около 1 млн строк на запрос и настраивается вплоть до 10–100 млн строк при увеличении объёма оперативной памяти сервера.
Почему обычный ИИ-агент не может просто загрузить большой файл в диалог?
Потому что у любой языковой модели есть ограничение по объёму контекста — данные, которые не помещаются в это окно, физически нельзя передать модели целиком за один раз.
Как агент «понимает» большие данные, если не читает их построчно?
Он анализирует набор данных статистически — так же, как это делает аналитик: смотрит на диапазоны, суммы, структуру и связи между таблицами, а не пытается удержать в памяти каждую отдельную запись.
Нужно ли заранее объяснять агенту, как связаны разные источники данных?
Нет — в демонстрации агент сам определил структуру и связи между тремя файлами без пояснений от пользователя.
Может ли агент работать напрямую с базой данных, а не только с выгруженными файлами?
Да — помимо 1С, поддерживается прямое подключение к PostgreSQL, MS SQL и к ClickHouse, что даёт дополнительный запас производительности на действительно больших аналитических запросах за счёт вычислений на стороне самой базы.
Может ли ИИ-агент построить дашборд по данным продаж?
Да. В демонстрации агент по текстовому запросу построил интерактивный дашборд с рейтингами, диаграммами и ABC-анализом по данным продаж на 700 тысяч строк и отправил его на почту. На один дашборд уходило около двух минут.