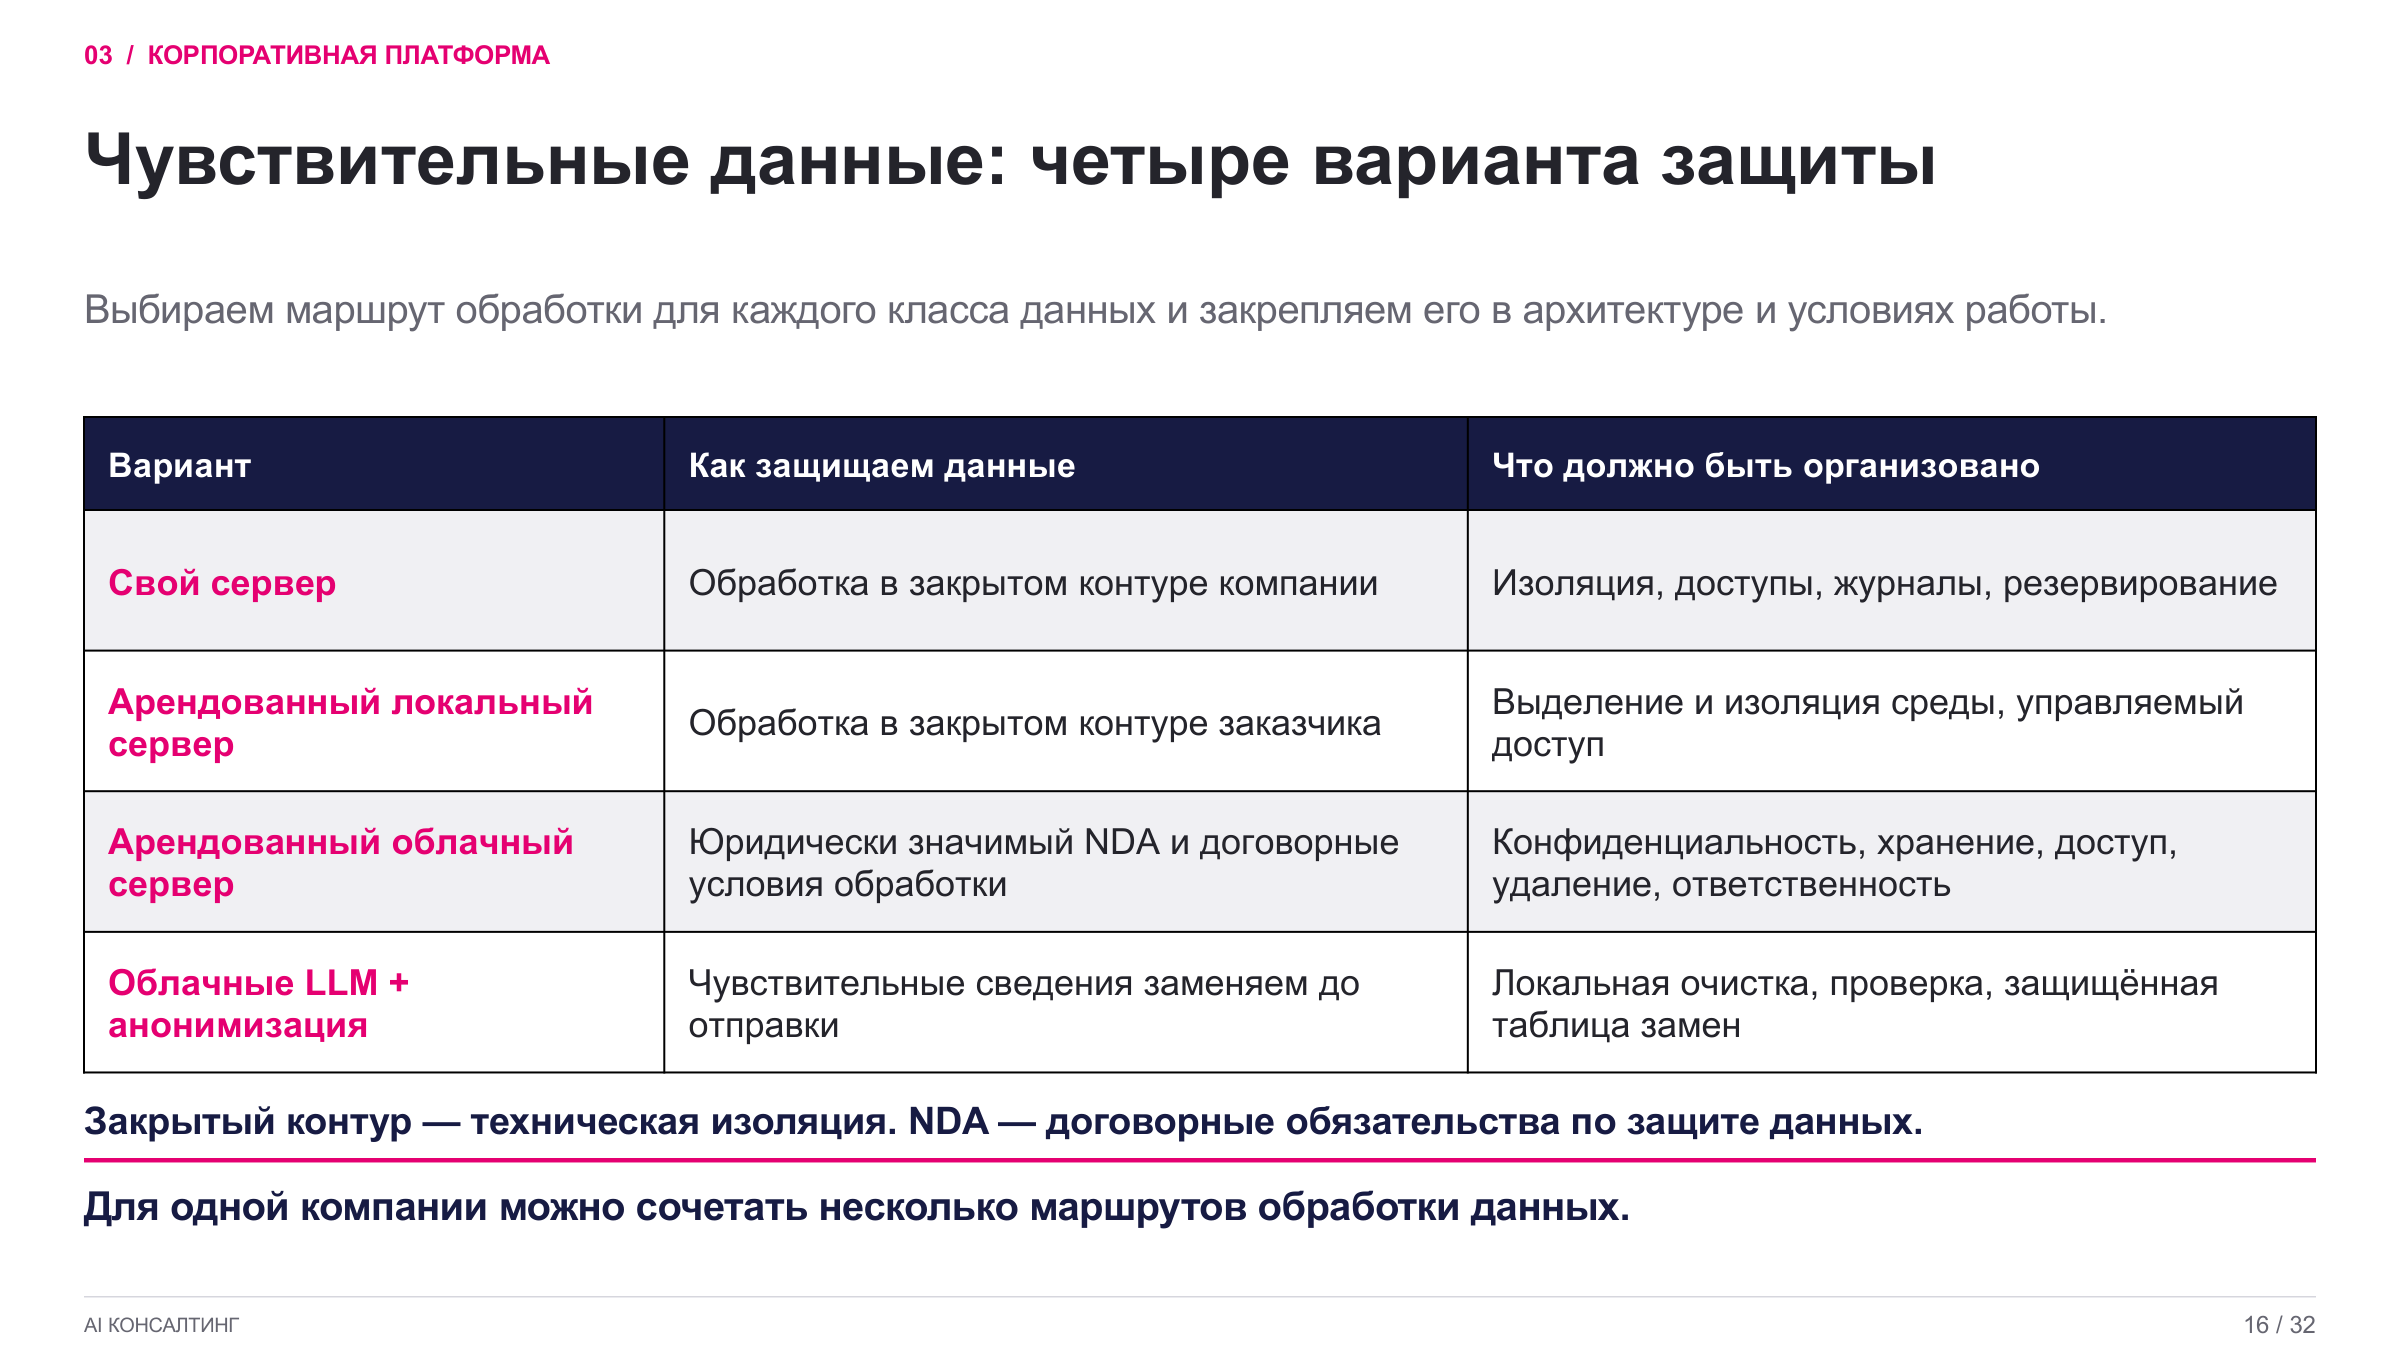
При работе с ИИ есть четыре принципиально разных способа защитить чувствительные данные компании — от полностью закрытого собственного сервера до облачной модели с анонимизацией данных перед отправкой.
Запуск сервера под простые LLM-модели обходится от 5–10 млн ₽ входа без услуг развёртывания, а под более «умные» модели — кратно дороже. Дальше в статье — как устроен каждый вариант, в чём его реальная цена и где он оправдан.
Вариант 1. Свой сервер
Максимально безопасный вариант: модель работает в закрытом контуре компании, данные физически не покидают периметр. Но это и самый дорогой вход — запуск сервера под LLM-исполнители (модели для типовых операций, не самые «умные» на рынке) обходится от 5–10 млн ₽, и это без учёта услуг развёртывания и подготовки инфраструктуры. Если нужны более продвинутые модели — сервер потребуется на порядок мощнее и дороже. Этот вариант оправдан, когда инфраструктура для ИИ — критическая для конкурентоспособности или самого существования бизнеса, а не эксперимент.
Вариант 2. Арендованный локальный сервер
Физически сервер стоит в помещении компании, но не куплен, а арендован. Это не обязательно дешевле покупки: в стоимость аренды закладывается маржа поставщика, который сам вложился в оборудование. Смысл в другом — железо для ИИ очень динамично устаревает, и пока вы купите сервер, дождётесь поставки и развернёте его, актуальная конфигурация может уже поменяться. Поэтому аренда — разумный путь для пилотов и экспериментов, где не хочется фиксировать капитальные вложения в оборудование, которое через год-два придётся менять.
Вариант 3. Арендованный облачный сервер с NDA
Здесь данные обрабатываются на чужом оборудовании где-то вовне, но с юридически значимым соглашением о неразглашении и договорными условиями обработки данных. Поставщик гарантирует конфиденциальность договором, а не физической изоляцией. Этот путь не подходит для персональных данных (закон здесь не оставляет выбора), но для остальной коммерческой информации вполне рабочий — на Западе это основной способ защиты данных при работе с ИИ, в России распространён меньше. По факту вопрос защиты здесь решается больше юридически, чем технически.
Вариант 4. Облачная модель с анонимизацией
Отдельный класс продуктов маскирует чувствительные данные до того, как они уходят в облачную модель. У подхода есть слабое место: анонимизаторы не гарантируют результат на 100% — если для какого-то типа данных не задан шаблон или маска, он может проскочить необработанным. А отследить единичную утечку внутри большого потока анонимизированного трафика практически невозможно. Разработчики таких решений сами не обещают полной гарантии вне узких, заранее протестированных сценариев использования.
Организационный вариант: просто не отправлять
Помимо технических решений есть организационный путь — ограничить категории данных, которые вообще можно передавать в ИИ, внутренними правилами компании. Например, не отправлять полный баланс компании со всеми деталями, но разрешить работу с данными, которые чувствительными на самом деле не являются. На практике заказчики нередко относят к чувствительным данные, которые таковыми не являются, — например, нормативно-справочную информацию, — и это приходится отдельно прояснять перед тем, как выбирать между дорогими техническими вариантами.
Как выбрать вариант для своей компании
Выбор редко сводится к одному варианту на всю компанию: разные классы данных разумно защищать по-разному. Персональные данные и наиболее чувствительная коммерческая информация — кандидаты на свой сервер или как минимум локальный контур; данные, для которых утечка некритична, — на облачные модели без лишних сложностей; всё, что посередине, — на аренду с NDA или анонимизацию, в зависимости от того, что важнее — договорные гарантии или техническая маскировка.
Частые вопросы
Сколько стоит развернуть свой сервер под ИИ?
От 5–10 млн ₽ входа под относительно простые LLM-исполнители, без учёта услуг развёртывания и подготовки инфраструктуры. Под более продвинутые модели нужны на порядок более мощные и дорогие серверы.
Подходит ли аренда облачного сервера для персональных данных?
Нет — для персональных данных юридически значимое NDA не отменяет требований закона к их обработке. Этот вариант подходит для остальной коммерческой информации, но не для персональных данных.
Можно ли доверять анонимизации данных на 100%?
Нет — анонимизаторы могут пропустить данные, для которых не задан шаблон маскирования, а отследить единичную утечку в большом потоке информации практически невозможно. Сами разработчики таких решений не гарантируют результат вне узких протестированных сценариев.
Можно ли использовать несколько вариантов защиты одновременно?
Да и на практике это обычная практика — разные классы данных в одной компании разумно защищать разными способами, а не искать один универсальный вариант на всё.